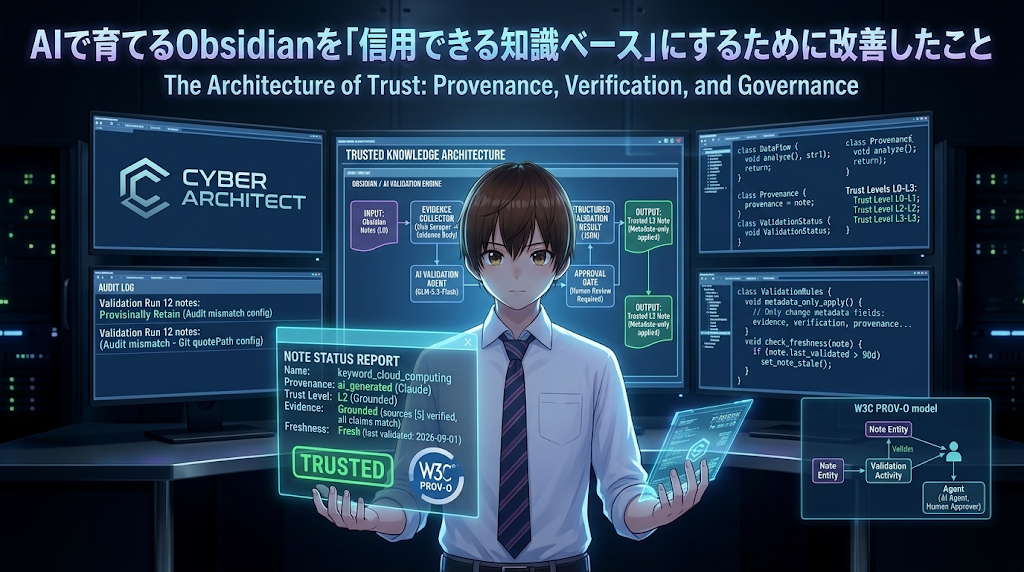
AIで育てるObsidianを「信用できる知識ベース」にするために改善したこと
私は日々の思考や調査の記録ツールとして、Obsidianを愛用しています。
最近ではClaude CodeやCodexなどのAIエージェントを組み合わせ、気になった専門用語や概念を調査して「Keywordノート」として自動生成・蓄積するパイプラインを構築・運用してきました。
AIの手を借りることで、知識ベースが広がる速度は劇的に向上します。以前なら調べるだけで数時間かかっていた領域でも、数分で要点がまとまり、関連ノートとのリンクが張られていきます。
しかし、ノートが増えるにつれて、ある根深い問題に直面することになりました。
「このノートに書かれている内容は、どこまで信用してよいのだろうか?」
もっともらしい文章が並び、末尾に参考URLが添えられていても、それだけで「確かな知識」とは言えません。引用元のWebページと本当に整合しているのか、時間が経って情報が陳腐化していないか、そもそもAIによる検証プロセス自体が正常に行われたのか——。
AIが生成する知識を個人の「第二の脳(Second Brain)」に組み込むためには、単なる生成の自動化から一歩進んで、「信用の状態(Trust / Provenance)」を客観的に管理・維持する仕組みが必要でした。
ここしばらくの間、私はVault内のKeywordノートに対する検証基盤を段階的に改善してきました。今回は、その試行錯誤のプロセスと得られた知見についてまとめます。
※執筆時点(2026年9月)の情報および個人環境での運用実績に基づいています。
考え方1:「生成元」と「検証状態」を明確に切り離す
「AIが書いたノートは信用しづらい」「人間が書いたノートなら安心」という単純な二元論では管理が破綻するなあ…とAIによって生成されたノートをみるについれ思うようになってきました。人間だって根拠レスのことノートに残しておきますからね。 「誰が書いたか」そのものよりも、「その記述がどこまで検証されているか」が記録されていないこと」が課題だと気がついた次第です。
ここで設計の拠り所としたのが、データの来歴(Provenance)をモデル化する国際標準規格である W3C PROV-O(The PROV Ontology)の考え方でした。
PROV-Oでは、世界を「実体(Entity)」「活動(Activity)」「行為者(Agent)」という3つの基本要素で捉えます。重要なのは、「誰が関わったか(Agentへの帰属)」と、「どういう処理を経て生成されたか(Activity)」を明確に切り離して記録する点です。
「AIが書いたか人間が書いたか」というAgentの属性だけで信頼性を決めるのではなく、「どのような検証Activityを経てこの状態になったのか」を記録できなければ、知識の信用は担保できません。
そこでノートのフロントマターにおいて、情報の出自(Agent)を表す provenance、検証の深さ(Activity)を表す verification、そして根拠(Entity)を表す evidence を分離して記録するように改めました。
provenance:
  origin: ai_generated
  generator: claude

verification:
  status: reviewed
  level: 2

evidence:
  status: grounded
source_count: 3ここで、検証の深さを客観的に測る基準として、Trust Level を以下のように4段階で定義します。
| Level | 名称 | 定義 |
|---|---|---|
| L0 | Unverified | 未検証。生成されたまま、あるいは検証ログが存在しない状態。 |
| L1 | Machine Review | LLMによる機械的な構文・論理チェックを通過した状態。 |
| L2 | Grounded | 外部Evidence(Web等の参考資料)の本文を取得し、記述内容と照合済みの状態。 |
| L3 | Primary Mapped | 一次情報を中心に、ノート内の各主張(claim)と情報源が一対一で対応付けられた状態。 |
重要なルールとして、「AIモデルの出力した確信度スコア(confidence score)が高い」という理由だけでTrust Levelを引き上げることは禁止としました。どれほどAIが自信満々に語っていても、外部の根拠と突き合わせるまではL2以上には昇格させない設計にしています。
なお、ここで挙げたL0〜L3は、信用の度合いを体系的に整理するための枠組みです。現在の私の運用では主にL1とL2を中心に活用しており、L3は一次情報との厳密な対応付けが必要な場合の発展段階として位置づけています。
考え方2:「URLの記載」と「Evidence本文の照合」を同列に扱わない
「参考文献のURLが記載されている」ことと、「そのURLの中身を読んで検証した」ことの間には、大きな隔たりがあります。
これまでは、ノートの末尾にURLが載っていれば、どこか安心感を覚えていました。しかし冷静に検証してみると、URLのリンク先が一般的なポータルサイトだったり、元の記事が主張している内容とは異なる文脈で参照されていたりするケースも起こり得ます。
PROV-Oの観点で見ても、ある検証処理(Activity)が成立したと言えるためには、単に「Web上にリンクがある」という外部ポインタだけではなく、実際にその内容をデータ実体(Entity)として入力に利用した(used)という事実が必要です。
URLが存在するだけでは、記述の裏付け(Evidence)にはなりません。
そこで、Vault側の検証パイプラインに、実際に参考URLへアクセスして本文テキストを取得し、ノート内の主張(claim)と1件ずつ突き合わせる処理を組み込みました。
ここで触れておきたいのは、「Validator(検証機)」の役割分担です。一つの巨大なプログラムがURLの取得からObsidianの書き込みまでを一気にこなすわけではありません。安全性を保つため、責務を明確に切り分けています。
- Vault側の収集処理: ノートにすでに記載されている公開URLからEvidence本文を取得し、ノート内の主張(claim)とともに検証用リクエストを組み立てます。
- Cloudflare Worker(判定サービス): MCPの
/mcpまたはREST API(POST /v1/validate)でリクエストを受け取り、Workers AIのGLM-5.3-Flash(@cf/zai-org/glm-5.3-flash)を呼び出して照合を行います。Worker自体はObsidianのファイルを一切読み書きしません。 - Workerからの判定返却: 照合結果(
pass/warn/fail/unverifiable)や指摘事項、スコア、確信度などを構造化されたJSONとして返す役割に徹します。 - Vault側の反映処理: Workerから返ってきた判定結果を受け取り、Vault側のポリシーに従ってステータスへ変換したうえで、後述する承認ゲートを経てメタデータに反映します。
つまり、外部のCloudflare Workerは「ノートを直接書き換えるエージェント」ではなく、渡された文章とEvidenceを客観的な基準で照合し、判定結果だけを返してくれる独立した検証サービスとして設計しています。
flowchart LR
    A["Keywordノート\n各Claim(主張)"] --> B["Vault側のEvidence収集"]
    B --> C["Cloudflare Worker\n/mcp または /v1/validate"]
    C --> D["GLM-5.3-Flash\n構造化判定"]
    D --> E["WorkerのJSON結果"]
    E --> F["Vault側のステータス変換\n承認後にmetadata-only反映"]
また、Workerが返す判定結果と、Vaultのfrontmatterへ記録するステータスも同一視していません。Workerの判定(pass / warn / fail / unverifiable)を、運用のポリシーに合わせて以下のようにVaultのステータスへとマッピングしています。
- verified / L2: Evidence本文が正常に取得でき、ノート内のすべての主張が裏付けられた状態(Workerの
pass)。 - reviewed / L2: Evidenceは取得できたものの、一部の主張について本文中に言及が見当たらなかった状態(Workerの
warnなど)。 - disputed / 要確認: 取得したEvidenceの内容とノートの記述に明らかな矛盾が見つかった状態(Workerの
fail)。機械的にL2へ昇格させることはせず、人間の目で確かめるべきフラグとして扱います。 - L1据え置き: ネットワークエラーやアクセス制限でEvidence本文が取得できなかった場合や、Workerが判定不能(
unverifiable)と返した状態。たとえURLが正しく記載されていても、本文の裏付けが取れなければL2には昇格させません。
「URLが置いてあるだけの状態」を排し、本文データを実際に取得して初めて根拠とみなすようにしたことで、ノートの信憑性は一段と高まりました。
試行後の気づき対応1:AIに書き換えを許す範囲を極小化する
自動検証の仕組みを動かし始めると、別の重大なリスクが浮上しました。
「検証のついでに、AIが本文の言い回しを直したり、良かれと思って新しい参考文献URLを書き足したりしてしまう」という問題です。
検証結果をVaultへ反映するプログラムに広い編集権限を与えていると、意図しない文面の改変や、検証されていないリンクの混入を招く恐れがあります。そこで運用の大原則として、Vault側で変更可能な範囲を verification と evidence のfrontmatterプロパティのみに限定する方針を採用しました。
本運用におけるこの制約を、metadata-only validation と定義します。
前述の通り、Cloudflare Worker自体はファイルを一切触らない読み取り専用のサービスです。したがって「metadata-only」という制約は、判定結果を受け取って自分のVaultへ書き戻すローカル側の処理に対して課している安全ルールです。
# Vault側の反映処理が変更可能な領域(ホワイトリスト)
verification: ...
evidence: ...

# ----------------------------------------------------
# 以下の領域はVault側の反映処理による変更を一切禁止
# - ノート本文(Markdown body)
# - references(参考文献一覧)
# - provenance(出自情報)
# - tags, titleなどの基本プロパティ
もしEvidenceが不足していて参考文献を追加したい場合でも、反映処理がその場でURLを勝手に挿入することはありません。「Evidence不足」というステータスを記録するにとどめ、URLの選定や修正は別の「改善工程(remediation)」として明示的に分離して行います。
「判定すること」と「内容を修正すること」を切り離したことで、自動検証を安心して回せる環境が整いました。
試行後の気付き対応2:時間による「陳腐化」を評価に組み込む
情報はナマモノです。検証した瞬間には100%正しかった内容も、時間の経過とともに仕様変更やサービス終了によって古くなっていきます。世界一長い河川の情報が「ミシシッピ川」からなかなか更新されなかった母親のことを思い出しながら考えたものです。
「一度L2に昇格したから永久に信用できる」というわけにはいきません。そこで、PROV-OにもあるFreshness(鮮度)という概念は必要なんだなと納得して導入しました。
以下の3つのトリガーが発生した場合、そのノートは「再検証が必要(stale)」とみなされます。
- content_changed: ノートの本文が手動または別プロセスで編集された。
- references_changed: 参考文献のリストが変更された。
- age_expired: 前回の検証から一定期間(標準設定では90日間)が経過した。
ノートのフロントマターには、以下のように次回の検証推奨期限を記録しておきます(※この期限管理はVault側の運用ルールとして計算・付与しているもので、Worker側の返却スキーマではなくローカル側で保持しています)。
verification:
  status: verified
  level: 2
  last_validated: 2026-09-01
  revalidate_after: 2026-11-30
この仕組みによって、Obsidian内のノート群を検索したりAIがRAG(検索拡張生成)の参照元としてノートを読み込んだりする際に、「L2であるかどうか」だけでなく「現在もFresh(最新状態)なL2であるか」をフィルタリングできるようになりました。
実装:段階的な改善プロセス
この検証基盤は、最初から完成形として作られたわけではありません。いきなりVault全体にスクリプトを適用するのではなく、ルール策定 → 現状把握 → 1件実証 → 安全化 → 段階的拡大 というフェーズを踏んで慎重に進めました。
| Stage | フェーズ名 | 主な目的と実施内容 | 次のステージへ進む判定条件 |
|---|---|---|---|
| A | Rule-only / Policy正式化 | provenance / verification / evidence のスキーマ定義、L0〜L3の基準、変更禁止範囲のルール化。 |
「何をもって信用とするか」の定義に曖昧さがないこと。 |
| B | Baseline | Vault全体の現状を読み取り専用で監査。母数(全80件、Evidence照合可能なノート73件)の確定。 | 対象範囲と初期のカバレッジが数値として把握できていること。 |
| C | Canary | まず1件のノートだけを対象に、Evidence本文取得からWorker照合・Vault側メタデータ更新までを実証。 | 小規模な本番環境で想定どおりの検証サイクルが回ること。 |
| C.5 | Metadata-only hardening | Canaryで見つかった「Vault側の書き込み処理が本文まで触れてしまう危険性」を遮断し、メタデータ限定更新を徹底。 | 本文や既存リンクを一切汚染しない防壁が確立されていること。 |
| D | Controlled pilot | 最大8件程度の少数ノートで、外部通信エラー(HTTP 502など)への耐性を確認。 | 外部エラー発生時でも安全に中断・記録でき、状態が壊れないこと。 |
| E | Progressive coverage | カバレッジを段階的に引き上げ(25% → 50% → 80%以上)。承認ガバナンスを確立。 | Fresh L2のカバレッジが80%以上に達すること。 |
特に大きな転換点となったのは、Canary(Stage C)の直後に設けた Stage C.5 でした。1件のテストを実際に走らせたことで、「Vault側の初期書き込み処理が本文のMarkdown記法に干渉してしまう危険性」に気づくことができたためです。ここで立ち止まり、メタデータ限定の書き換え制約を固めたことが、その後の安全な拡大を支える土台となりました。
結果:実測データで見る改善成果
感覚的な「良くなった気がする」で終わらせないため、読み取り専用の監査スクリプトを整備し、数値を継続的にトラッキングしました。
検証対象は80件のキーワードノートのうち73件ででStage Eの最終段階における実測値は以下の通りです。
Raw Keywords: 80
Evidence-capable: 73
Fresh L2: 59
Coverage: 80.82%
80% threshold: 59
Threshold surplus: 0
目標として掲げていた「80%以上のカバレッジ」は達成できました。
しかし、ここで注目すべき数値は Threshold surplus: 0(しきい値に対する余裕がゼロ) である点です。73件中59件という数字は、ちょうど80.82%であり、もし1件でも期限切れ(stale)になれば即座に80%を割り込みます。
この測定結果を得たことで、「一度80%を超えたから終わり」ではなく、「ここから継続的な品質維持(Maintenance)の戦いが始まる」 という事実を客観的に認識することができました。
学び1:失敗した処理を「成功」にしない——手順と結果の健全性を分ける
検証処理を運用する中で、特に重要だった学びがあります。それは、「得られたデータが正しそうだからといって、実行プロセスそのものが成功したことにしてはならない」という点です。
ある検証バッチにおいて、12件のノートに対するメタデータ更新自体は正常に行われていたものの、実行後の整合性チェック(意図しないファイル変更がないかを確かめるスコープ検証)でエラーが発生する事態が起きました(※このとき起きたツール側の具体的なトラブルについては、記事末尾の補足コラムにまとめています)。
このとき、「実際に生成されたデータに問題はないのだから、この実行も成功(SUCCESS)扱いにして先に進めてしまおう」という誘惑が頭をよぎりました…がCodexが即座に止めに入りました。
それを許してしまうと、「そのデータが本当に正規の手順と検証を経て作られたものか」を後から追跡する監査履歴(Auditability)が壊れてしまいます。
ここでもPROV-Oの原則が活きています。PROV-Oでは、生成された成果物(Entity)と、それを生み出した処理プロセス(Activity)は別個の存在として管理されます。プロセスの検証に不整合があるにもかかわらず「結果データが合っているから成功」としてしまうと、データの来歴グラフそのものが偽りになってしまうためです。
そこで、運用の大原則として「実行プロセスの健全性(Process Integrity)」と「結果データの健全性(Result Data Integrity)」を明確に分けて評価・記録する方針をとりました。
Runステータス:
FAILED / CONSUMED (実行手順としては失敗とし、この実行枠は消費済みとする)

検証結果ステータス:
PROVISIONAL RETAIN (生成されたデータは破棄せず、暫定保持として扱う)
「最終データが正しいこと」と「正しい手順で実行されたこと」は同じではありません。この境界線を曖昧にしないことこそが、後から振り返ったときに揺らがない「信用」の土台になります。
学び2:自動化するのは「実行」ではなく「発見」まで
検証の仕組みが整ってくると、次に湧いてくるのが「すべてを自動化したい」という欲求です。
「Cronで毎日巡回し、期限切れや新規のノートを見つけたら、AIが外部APIを呼び出して自動で検証・更新まで完了してくれれば楽ではないか」と考えたくなるのは自然な流れです。
しかし、AIエージェントに本番環境への書き込み権限を全面的に委ねることには慎重であるべきです。意図しない大量のAPI課金や、外部サイトの仕様変更による誤判定、Vault全体の整合性破壊などのリスクが常に潜んでいます。
「自動化できること」と「自動化すべきこと」は違います。
そこで、自動化する範囲は「監査と候補の検出(read-only)」までに厳密に限定し、実際のデータ反映には人間の明示的な承認ゲートを挟むアーキテクチャに落ち着きました。
flowchart TD
    A["定期実行(スケジュール)"] --> B["read-only audit(全ノート走査)"]
    B --> C["期限切れ・要再検証候補の自動検出"]
    C --> D["人間に通知・ダッシュボード表示"]
    D --> E{"人間による確認"}
    E -->|"差分・対象を承認\n(Challenge-Response)"| F["本番反映(Production実行)"]
    E -->|"保留・調整"| G["何もしない(データ保護)"]
具体的には、単に「OK」「進めて」と返事するだけでは本番実行できず、対象ファイルのハッシュ値から生成された承認用ダイジェストを入力するChallenge-Response方式(APPROVE_PRODUCTION <digest>)を採用しています。
「判断材料を揃えるまでは自動、最終的な引き金を引くのは人間」という線引きを維持することが、システムを壊さずに長く共存するための現実的な解でした。
次のステップ:Stage F「Trust Maintenance」への移行
Stage Eでカバレッジ目標(80%以上)を達成したことを受け、現在は Stage F(Trust Maintenance & Quality) へ移行しています。
ここでの目的は、カバレッジの数値を無理に100%まで引き上げることではありません。一度確立した「信用」を、日々の運用の中で劣化させずに維持し続けることです。
具体的には、次回検証期限の到来に対して以下のような段階的な監視ルールを設けています。
- 期限まで7日以内: 次期バッチ実行の候補としてリストアップ。
- 期限まで8〜14日: 準備ステータス。近々期限を迎えるノートとして集約。
- 期限まで15〜30日: 監視ステータス。急ぎの対応は行わない。
- 期限まで30日超: 対象外。
まだ期限に十分な余裕があるノートまで前倒しで再検証してしまうと、90日間の有効期限(TTL)を無駄に短縮してしまい、API呼び出しコストや外部サーバーへの負荷を無駄に増やすことになります。「適切なタイミングで、必要な分だけ検証する」という節度を持ったサイクルを構築しています。
まとめ:AI時代に求められる「信用のアーキテクチャ」
今回の取り組みを振り返ると、単に「Obsidianのスクリプトを作って便利にした」という範囲にとどまらず、「AIが生成した知識を、人間がどう責任を持って信用し続けるか」というガバナンスの設計そのものであったと感じています。
AIの進化によって、知識のドラフトを作成するコストは限りなくゼロに近づきました。しかし、その知識を安心して日々の意思決定や思考の道具として使うためには、以下の原則が欠かせません。
- 出自(Provenance)と検証度合い(Verification)を別物として管理すること
- URLの存在ではなく、実際の本文データに基づく照合を行うこと
- AIに変更を許すスコープを最小限(Metadata-only)に抑えること
- 手順の正しさとデータの内容を混同せず、監査ログを正確に残すこと
- 自動化の境界線を「検出」に引き、本番反映には人間の意思を介在させること
AIを活用した知識ベースの構築において、真に差別化を生むのは「いかに速く文章を生成するか」ではありません。PROV-Oが示すように、「誰が作り、どの根拠実体(Entity)を使い、どのような承認手順(Activity)を経てここに記録されたのか」という客観的な来歴(Provenance)を、いかに透明かつ再現可能な形で説明できるかという仕組みの強さにあります。
このアプローチはObsidianに限らず、社内Wikiや社内ナレッジベース、RAGシステムの運用全般においても、そのまま再利用可能な普遍的な教訓であると考えています。
(補足コラム)GitのUnicodeパス問題
第7章で触れた「実行プロセスの検証エラー」の具体的な原因について、記録しておきます。
検証バッチの完了時、スクリプトはGitの変更差分を走査し、「事前に指定された対象ノート以外のファイルが意図せず書き換えられていないか」を厳密にチェック(スコープ検証)しています。
ところが、日本語を含むノート名を処理した際、Gitの標準出力がファイル名をクォート文字付きの8進数エスケープ("\343\202..." のような形式)で返していました。その結果、スクリプト側が保持していたUTF-8のファイル名文字列と一致せず、「未知のファイルが変更された」と誤判定されてしまったのです。
Gitのデフォルト設定では、非ASCII文字を含むパス名をエスケープして出力する仕様(core.quotePath = true)になっています。
# 対策:非ASCII文字をそのまま出力させる設定
git config --local core.quotePath false
ツール連携における些細なパス表記の違いひとつでも、スコープ検証という安全装置が正しく働いたからこそ検知できたトラブルでした。本筋のアーキテクチャからは脇道の実装トラブルですが、日本語ファイル名を多く扱うObsidian環境では覚えておいて損のないポイントです。
参考資料
参照規格・ドキュメント(公式・仕様)
- W3C PROV-O (The PROV Ontology): データ来歴(Provenance)の表現モデル
- Obsidian Properties 公式ドキュメント: YAML形式のProperties仕様
- Git
core.quotePath公式ドキュメント: 非ASCII文字を含むパスの出力仕様 - Cloudflare Workers AI: GLM-5.3-Flash: Workerから呼び出すモデルとモデルID
- Cloudflare Agents: Remote MCP server:
/mcp入口の構成 - Cloudflare Agents: MCP handler APIs:
createMcpHandler()によるステートレスMCPハンドラー